用 Hexo 和 Butterfly 做一个论文库页面:一次从抄作业到落地的完整记录
起因
看到两个论文库网站,把2026年的ICLR和ICML的所有论文扒下来用LLM做了中文导读,还有研究方向的分类,非常具有参考价值:
https://jenniferzhao0531.github.io/ICLR2026-Guide-CN/
https://tsrigo.github.io/ICML2026-Guide-CN/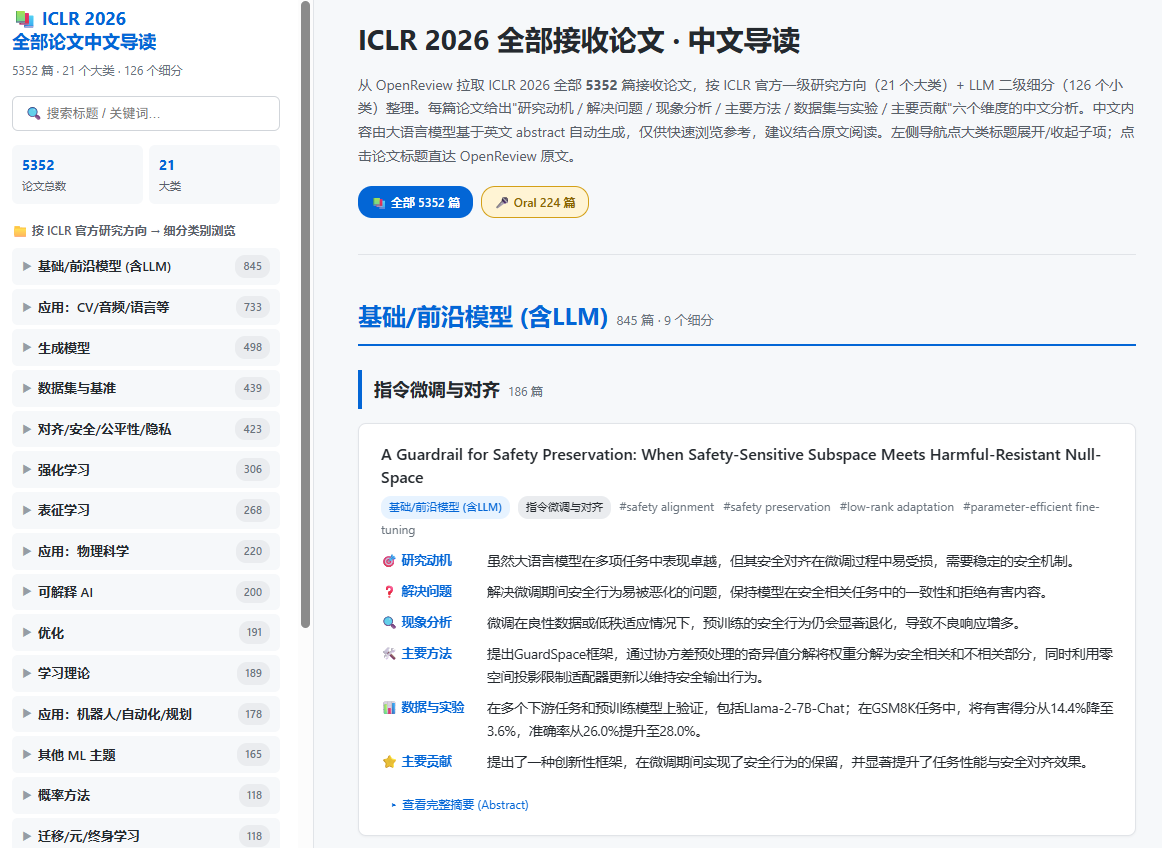
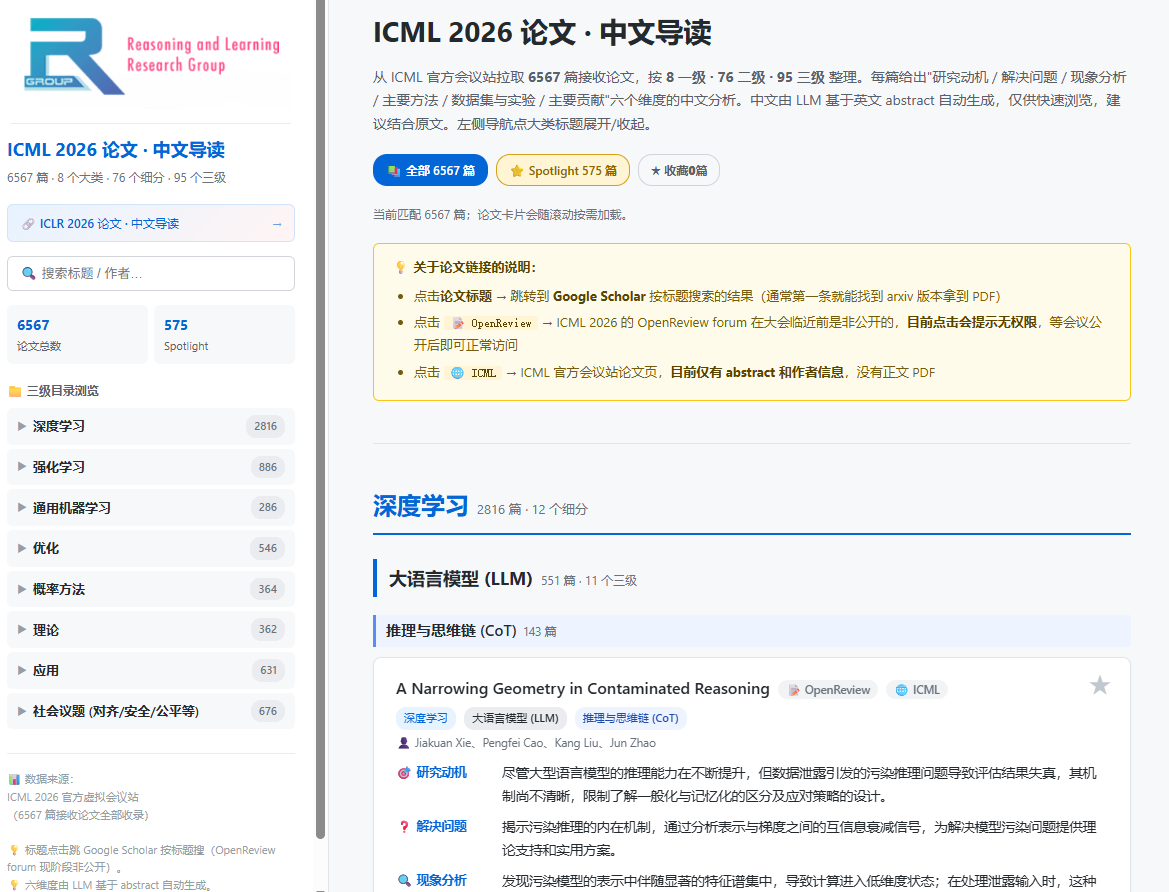
于是想到:平时泛读的论文能不能也做一个类似的论文库,用于快速浏览、进行参考呢?
本地的笔记收录了论文的元信息和英文摘要,并且按照自己的思路进行了分类,和参考站相比,再用LLM按照摘要做解读就可以了。既然参考站能跑在 GitHub Pages 上,那我的论文库能跑在我的 Hexo 站点里吗?
让deepseek帮我看一下是否可行🧐
Hexo+Butterfly 能不能做到
我的站是 Hexo 7.3 + Butterfly,部署在自建服务器上。动手前先确认了原生能力边界,避免走弯路。
| 参考站的能力 | Butterfly 现状 |
|---|---|
| 三级树状侧栏 + 每级计数 | ❌ 侧栏是固定 widget(作者卡 / 最近文章 / 分类 / 标签),塞不进自定义树 |
| 一页内按分类聚合 | ❌ Hexo 分类支持多级,但渲染成「归档列表」,不是同页聚合 |
| 全站秒搜 | ⚠️ hexo-generator-searchdb 已经装了,但 search.use: 是空的,搜索其实是关的 |
| 折叠卡片 | ✅ collapse / note / tabs 标签插件可以 |
| 文章内目录 | ✅ 但 75 篇论文挤在一篇里,TOC 会长到没法用 |
结论:Butterfly 原生做不到,但不是技术做不到,是「承载方式」不对。
参考站本身就是个单文件静态 HTML——没有框架、没有后端,一个 <script id="paper-data" type="application/json"> 里塞了全部论文数据,剩下全靠前端 JS。
所以方案定为:不动主题,把论文库做成一个预生成的独立静态页。
关键一环:skip_render
D老师让脚本把页面生成到 source/papers/index.html。然后第一次 hexo generate,打开一看——炸了。
页面确实生成了,但它的 <head> 里出现了 Butterfly 的东西:
1 | <html lang="zh-CN" data-theme="light"> |
Hexo 把 source/papers/index.html 当成了一个普通 page,套上了主题的 page 布局。 整个 HTML(包括 <style>)被塞进了主题的 <head> 里,页面结构彻底报废。
原因是:source/ 下的文件只要 Hexo 能处理,就会被当文章/page 渲染。要让它原样拷贝,得显式声明:
1 | # _config.yml |
改完立刻 hexo generate——还是坏的。差点以为方法不对。
其实是 Hexo 的缓存:它认为这个文件没变,复用了上次渲染的结果。必须 hexo clean 一次:
1 | npx hexo clean && npx hexo generate |
之后用哈希对比确认它是原样拷贝的:
1 | if ((Get-FileHash 'public\papers\index.html').Hash -eq (Get-FileHash 'source\papers\index.html').Hash) { "原样输出 ✓" } |
踩坑提示:
skip_render生效后一定要hexo clean。
菜单接入就一行:
1 | # _config.butterfly.yml |
数据管道:一条不能全自动的流水线
75 篇论文的「结构化解读」没法脚本化——那需要真读懂摘要。但除了这一步,剩下的全可以自动化。
D老师把它拆成了这样:
1 | 草稿.md |
从草稿解析元数据这一步可以放心交给D老师,尽管D老师吐槽“比想象中麻烦”。
草稿长这样:(确实是平时做记录的时候没有结构化。)
1 | #### (arxiv 2026.08 通过蒙特卡洛树搜索从多个候选拓扑中选取节点)HELENA:Hierarchical Sparse Coordination... |
至于那 6 批解读,D老师拆给了 6 个并行的 LLM 任务,每个负责一个分区,产出统一的 JSON schema:
1 | { |
草稿里的中文摘要是机器翻译的,不能直接用。D老师提前列了一张术语对照表塞给子代理,并点名了已知的机翻错误。事后扫描确认全库零残留。D老师会给子代理写好任务规范,挑第一个子代理的prompt看一下:
1 | 你在 Windows 上的一个 Hexo 博客仓库里工作,工作目录是 `D:\Blog\my-blog`。 |
Deepseek-V4-Flash看不见页面,怎么验证
D老师用无头 Chrome 注入一段探针脚本,把布局和交互的实测结果 dump 出来:
1 | var out = []; |
配 --dump-dom 读结果:
1 | sidebar=340x805@0,0 pos=sticky main=1069x39387 无横向滚动 |
最后那行证明 75 篇的解读字段一篇都没漏。
顺带一提:
papers=75和anKeys里的 75 是完全独立的两个统计口径,能对上才说明数据和渲染是一致的。
论文库的后续维护
和参考站不一样的是,参考站已经扒下了会议中所有的论文,不需要增加、删除和修改了。而我的论文库还会一直更新。D老师第一版做的方案里有两个大坑,是从草稿解析时埋下的:
坑 A:用「第几篇」当 ID
第一版里论文的 ID 是 p001、p002……按它在草稿里的顺序编号。解读文件也按这个 ID 索引。
听起来没问题,直到在中间插入一篇新论文:
1 | 插在第 3 篇之前 → |
这是最危险的一类 bug:不报错,只是默默给你错误的内容。
修法是让 ID 只依赖论文标题,不依赖位置——取英文标题派生一个 slug:
1 | "HELENA: Hierarchical Sparse Coordination over a Union of ..." → helena |
规则是优先取冒号前的方法名(大多数论文标题都是「方法名: 描述」的结构),没有冒号就取标题前 5 个单词。
实测验证过:在草稿中间插一篇新论文,其余 75 篇的解读零漂移,只有新论文被正确地报「缺少解读」。
代价是改了标题就等于改了 ID,不过这个有办法兜(见下一节)。
坑 B:改了二级标题,17 篇论文凭空消失
页面的分类树是从一个 taxonomy.json 里定义的,一级大区显式列着它包含哪些二级分区。而二级分区的名字,就是草稿里的 ### 标题。
所以:在草稿里把 ### MAS拓扑设计 改成别的名字,却没同步 taxonomy.json,那 17 篇论文就从页面上消失了——它们还在数据里,但不属于任何一级大区,所以不会被渲染。构建显示成功。
第一版的校验只检查了「论文总数对不对」,这种消失完全检测不到。
修法:把构建分成「能过」和「过不去」两档
D老师把校验重写了一遍,结构性问题一律致命,直接非零退出、不写任何文件:
- 某篇论文没有解读
out/里有草稿中不存在的 ID(标题改了导致 ID 漂移)- 某个二级分区没有被任何一级大区认领 ← 就是坑 B
- 分类树覆盖的论文数 ≠ 论文总数 ← 兜底防线
- 必填字段为空
- 某篇的三级子方向不在该分区声明的标签里
现在改了标题不配套,得到的是这个:
1 | ✗ 致命错误 19 条,已中止(未写出 papers.json): |
报错直接告诉你去哪改、怎么改。这比「构建成功但少了 17 篇」好一万倍。
给未来留的第三个机制:源指纹
前面提到,页面上的会议 / 年份 / 期刊等级只从解读文件读,草稿里那行 (arxiv 2026.08 …) 页面根本不看。
这就埋了个雷:论文从 arXiv 变成正式发表了,去草稿里改成 (NeurIPS 2026 …),页面一个字符都不会变。
于是D老师加了个指纹机制:每篇在产出解读时,把草稿的「会议注释 + 标题 + 中英摘要」算一个哈希存下来。构建时重算比对,不一致就提示:
1 | 提示 4 条: |
这顺带解决了另一个问题:改写了某篇的摘要,还记得去更新它的解读吗? 指纹会替你记着。
再配一个按 ID 改元数据的命令行工具,改会议信息就是一行:
1 | node tools/papers/edit.mjs emas --venue "NeurIPS 2026" --venueNote "CCF-A 会议" --year 2026 |
它会自动定位这篇落在哪个文件里(我拆了 6 个批次文件),不用手动 grep。
最后的结果
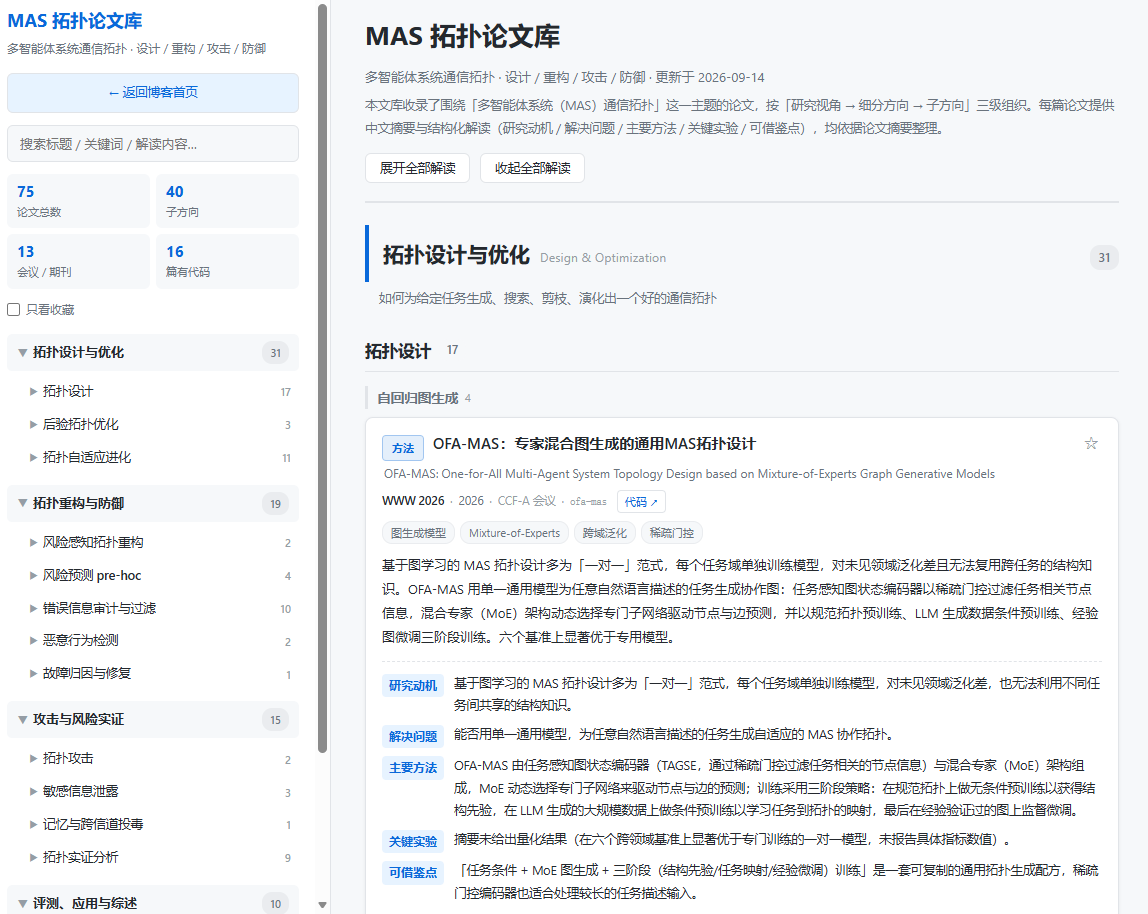
页面本体 901 KB,纯静态,无框架无后端:
- 75 篇论文,一级 4 个大区 → 二级 16 个方向 → 三级 40 个子方向
- 左侧三级折叠树,每级带数量角标;搜索时实时过滤,并同步更新各级计数、隐藏空分区
- 每张卡片:中文译名 + 英文原题 + 会议年份 + 类型徽章 + 关键词 + 重写的中文摘要,加上研究动机 / 解决问题 / 主要方法 / 关键实验 / 可借鉴点 五段解读
- 客户端搜索(支持搜解读正文)、收藏(localStorage)、一键展开/收起全部解读、快捷键
/聚焦搜索 - 英文原始摘要折叠,深色模式跟随系统
有意思的一个副产品:75 篇里有 38 篇的摘要根本没给出量化结果。这些是靠摘要判断不了成色的,真要引用得回去读原文。
几条可复用的经验
- 抄一个站之前,先看清它是什么。 把参考站扒下来才发现是单文件静态 HTML + 一段 JSON。看清了这个,方案自然就出来了。
- Hexo 部署独立静态页要
skip_render,改完记得hexo clean。 缓存会让你在一个已经修好的问题上反复怀疑自己。 - 不要用位置当标识符。 不管在什么系统里,只要数据源可能被插入元素,「第几项」就是定时炸弹。用内容派生的稳定标识。
- 静默失败比崩溃危险得多。 「构建成功但少了 17 篇」远比「构建失败」糟糕。凡是能自动校验的,就让它失败得响一点。
- 让 LLM 产出结构化结果时,先写规范再开工。 我把术语对照表、字段约束、三级标签的设计规则都写进了一份规范文档,再分给 6 个并行任务。事后扫描确认全库零术语残留——如果靠事后返工,成本会高得多。
整个工具链放在 tools/papers/ 里,包含解析、拆分、合并、渲染、校验、编辑脚本和两个说明文档。这套东西一次写好,以后加论文、改会议信息、调分类,都有明确的流程可以走。
请教D老师的时间与开销
这次用的是DSH搭配DeepSeek-V4-Flash,完成整个论文页面库设计和实现,加上修bug和写后续维护文档的时间,一共是35分钟左右,花费¥5.43。虽然V4只是文本模型,没法在页面上截图验证,但是参考站和本站都是静态页面,可以从html中验证。D老师使用无头 Chrome 注入一段探针脚本,把布局和交互的实测结果 dump 出来。这说明有的功能不一定非要视觉模型,文本模型+tools也能完成,主要是看任务场景是否适配。
 微信
 支付宝